Sort 7

[프로그래머스] 예산

https://school.programmers.co.kr/learn/courses/30/lessons/12982 프로그래머스코드 중심의 개발자 채용. 스택 기반의 포지션 매칭. 프로그래머스의 개발자 맞춤형 프로필을 등록하고, 나와 기술 궁합이 잘 맞는 기업들을 매칭 받으세요.programmers.co.kr  전형적인 그리디(Greedy) 유형의 문제다. 우선 코드부터 올리도록 하겠다. ㅇㅅㅇ def solution(d, budget): d.sort() total = 0 cnt = 0 for i in d: if total + i   total = 예산을 지원한 총액cnt = 예산을 지원받은 부서의 개수 이 문제의 핵심은 작은 금액을 요청한 부서부터 예산을 제공해주..

[프로그래머스] 나누어 떨어지는 숫자 배열

https://school.programmers.co.kr/learn/courses/30/lessons/12910 프로그래머스코드 중심의 개발자 채용. 스택 기반의 포지션 매칭. 프로그래머스의 개발자 맞춤형 프로필을 등록하고, 나와 기술 궁합이 잘 맞는 기업들을 매칭 받으세요.programmers.co.kr 리스트에 있는 원소를 하나하나씩 diviosor로 나누어떨어지는지 확인하고, 나누어 떨어진다면 비어있는 리스트인 result에 하나씩 추가하였다. 만약 연산 이후에도 result에 하나의 원소도 없다면, 문제의 요구대로 -1만 삽입해주도록 예외처리를 해주었다. def solution(arr, divisor): result = [] for i in range (len(arr)): ..

[Python] 튜플 정렬

파이썬에서는 튜플을 원소로 하는 리스트가 있을 때, 그 리스트를 정렬하면 기본적으로 각 튜플을 구성하는 원소의 순서에 맞게 정렬된다는 특징이 있다. 예를 들어 튜플이 3개의 원소로 구성된다면 모든 원소가 첫 번째 원소의 순서에 맞게 정렬되고, 첫번째 원소의 값이 같은 경우 두 번째 원소의 순서에 맞게 정렬되고, 거기에 두 번째 원소의 값까지 같은 경우 세 번째 원소의 순서에 맞게 정렬된다. 아래의 소스코드를 보자. 소스코드 a = [(5, 1, 5), (3, 5, 5), (3, 1, 9), (3, 1, 1)] a.sort() print(a) 결과 [(3, 1, 1), (3, 1, 9), (3, 5, 5), (5, 1, 5)] 또한 리스트의 원소를 정렬할 때는 sort() 함수의 key 속성에 값을 대입하..

Algorithm/Python 2023.08.01

[Algorithm] 계수 정렬

계수 정렬 알고리즘은 특정한 조건이 부합할 때만 사용할 수 있지만 매우 빠른 정렬 알고리즘이다. 데이터의 계수가 N, 데이터 중 최댓값이 K일 때, 계수 정렬은 최악의 경우에도 수행 시간 O(N + K)를 보장한다. 계수 정렬은 이처럼 매우 빠르게 동작할 뿐만 아니라 원리 또한 매우 간단하다. 다만, 계수 정렬은 '데이터의 크기 범위가 제한되어 정수 형태로 표현할 수 있을 때'만 사용할 수 있다. 예를 들어 데이터의 값이 무한한 범위를 가질 수 있는 실수형 데이터가 주어지는 경우 계수 정렬은 사용하기 어렵다. 일반적으로 가장 큰 데이터와 가장 작은 데이터의 차이가 1,000,000을 넘지 않을 때 효과적으로 사용할 수 있다. 계수 정렬이 이러한 특징을 가지는 이유는, 계수 정렬을 이용할 때는 '모든 범위..

Algorithm/Sort 2023.02.12

[Algorithm] 퀵 정렬

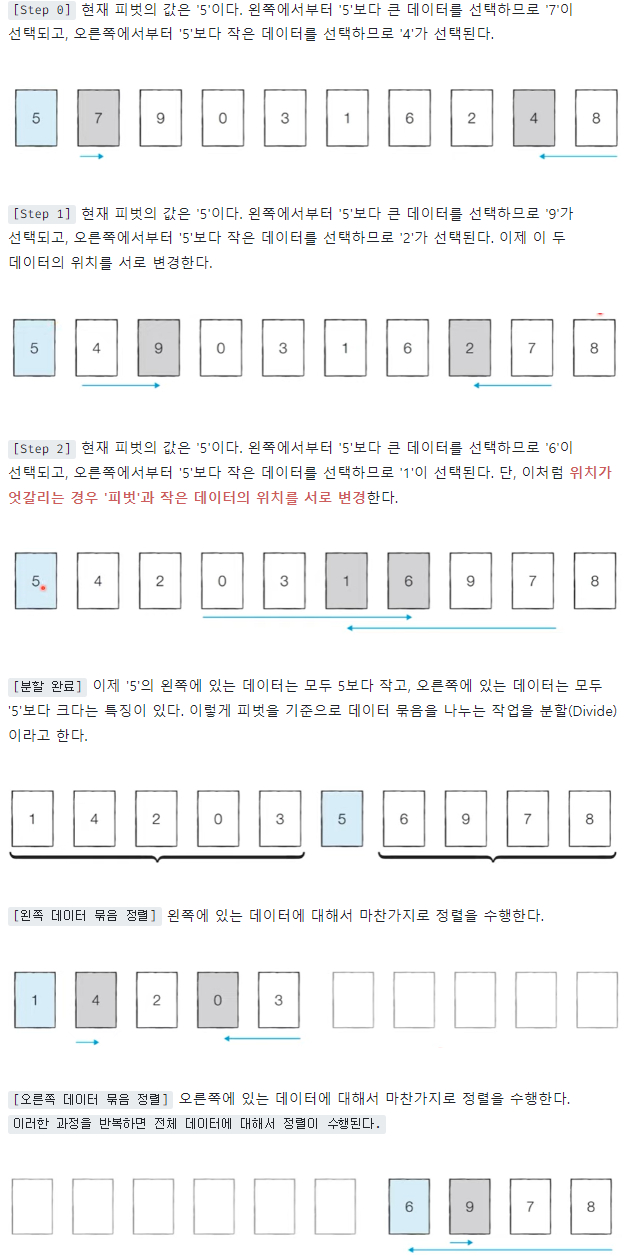
퀵 정렬은 정렬 알고리즘 중에 가장 많이 사용되는 알고리즘이다. 퀵 정렬과 비교할 만큼 빠른 알고리즘으로는 병합 정렬이 있다. 이 두 알고리즘은 대부분의 프로그래밍 언어에서 정렬 라이브러리의 근간이 되는 알고리즘이기도 하다. 퀵 정렬은 기준을 설정한 다음 큰 수와 작은 수를 교환한 후 리스트를 반으로 나누는 방식으로 동작한다. 퀵 정렬에서는 피벗(Pivot)이 사용된다. 큰 숫자와 작은 숫자를 교환할 때, 교환하기 위한 기준을 바로 피벗이라고 표현한다. 퀵 정렬을 수행하기 전에는 피벗을 어떻게 설정할 것인지 미리 명시해야 한다. 피벗을 설정하고 리스트를 분할하는 방법에 따라서 여러 가지 방식으로 퀵 정렬을 구분하는데, 여기서는 가장 대표적인 분할 방식인 '호어 분할 방식' 을 기준으로 퀵 정렬을 설명하겠..

Algorithm/Sort 2023.02.12

[Algorithm] 삽입 정렬

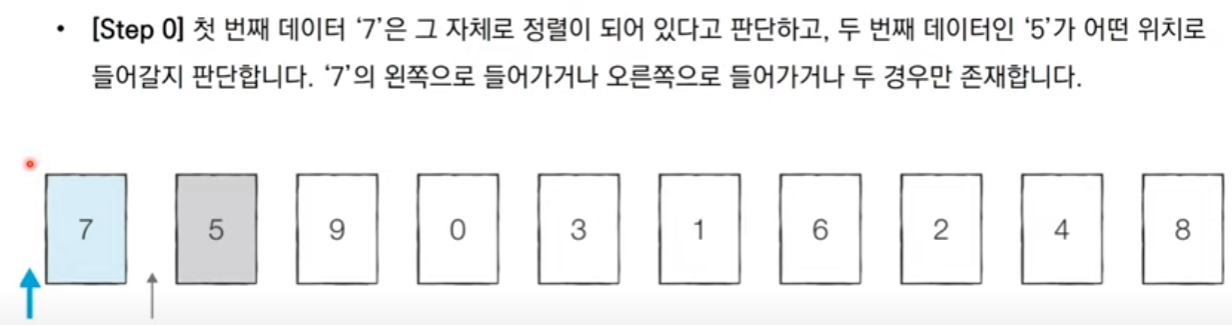
삽입 정렬은 선택 정렬에 비해 구현 난이도가 높은 편이지만 선택 정렬에 비해 실행 시간 측면에서 더 효율적인 알고리즘으로 잘 알려져 있다. 특히 삽입 정렬은 필요할 때만 위치를 바꾸므로 '데이터가 거의 정렬 되어 있을 때' 훨씬 효율적이다, 선택정렬은 현재 데이터의 상태와 상관없이 무조건 모든 원소를 비교하고 위치를 바꾸는 반면 삽입 정렬은 그렇지 않다. 삽입 정렬은 특정한 데이터를 적절한 위치에 '삽입'한다는 의미에서 삽입 정렬이라고 부른다. 더불어 삽입 정렬은 특정한 데이터가 적절한 위치에 들어가기 이전에, 그 앞까지의 데이터는 이미 정렬되어 있다고 가정한다. 정렬되어 있는 데이터 리스트에서 적절한 위치를 찾은 뒤에, 그 위치에 삽입된다는 점이 특징이다. 다음과 같은 예제를 생각해보자. 특정한 데이터..

Algorithm/Sort 2023.02.12

[Algorithm] 선택 정렬

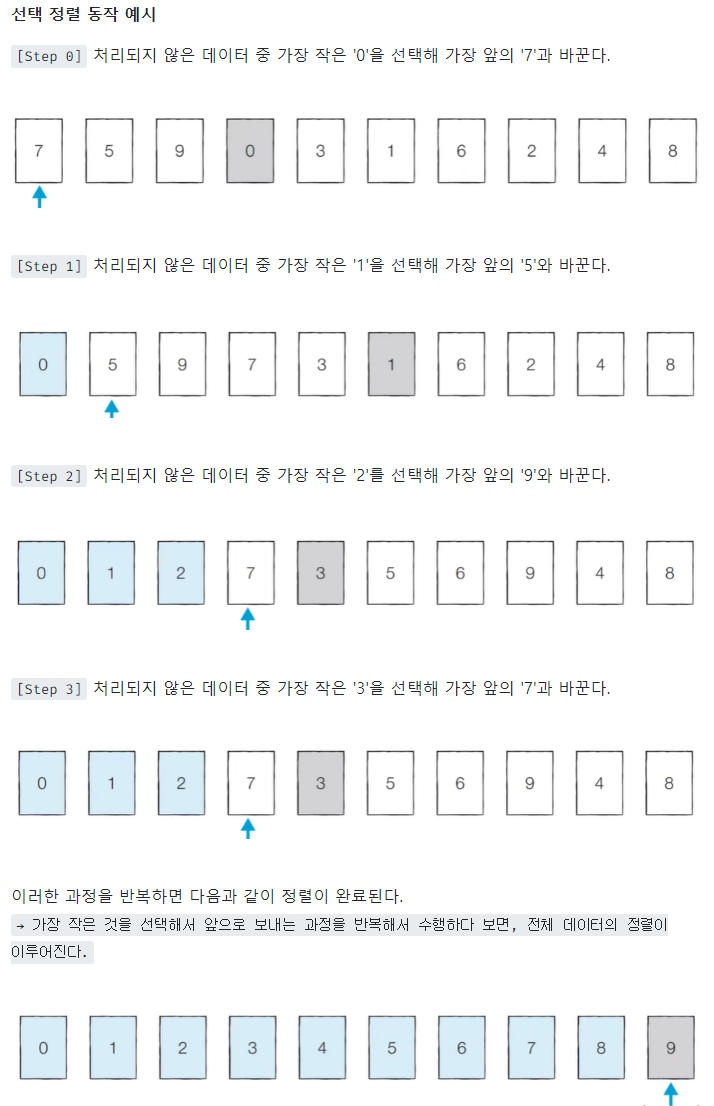
선택 정렬은 데이터가 무작위로 여러 개 있을 때, 이 중에서 가장 작은 데이터를 선택해 맨 앞에 있는 데이터와 바꾸고, 그 다음 작은 데이터를 선택해 앞에서 두 번째 데이터와 바꾸는 과정을 반복하는 것이다. 예제를 통해 자세한 동작 원리를 알아보자. 이처럼 선택 정렬은 가장 작은 데이터를 앞으로 보내는 과정을 N - 1번 반복하면 정렬이 완료된다. 외부의 루프를 (N-1)번 도는 동안, 각 자리에 와야하는 최댓값을 구하기 위하여 N-1, N-2, N-3, ... , 1번의 비교연산을 수행한다. 따라서, T(n) = (n-1)+(n-2)+(n-3)+...+1 = (n-1)*n/2 시간복잡도는O(n) = n^2 이다. 파이썬으로 소스코드를 작성해보면 다음과 같다. array [7,5,9,0,3,1,6,2,4..

Algorithm/Sort 2023.02.11